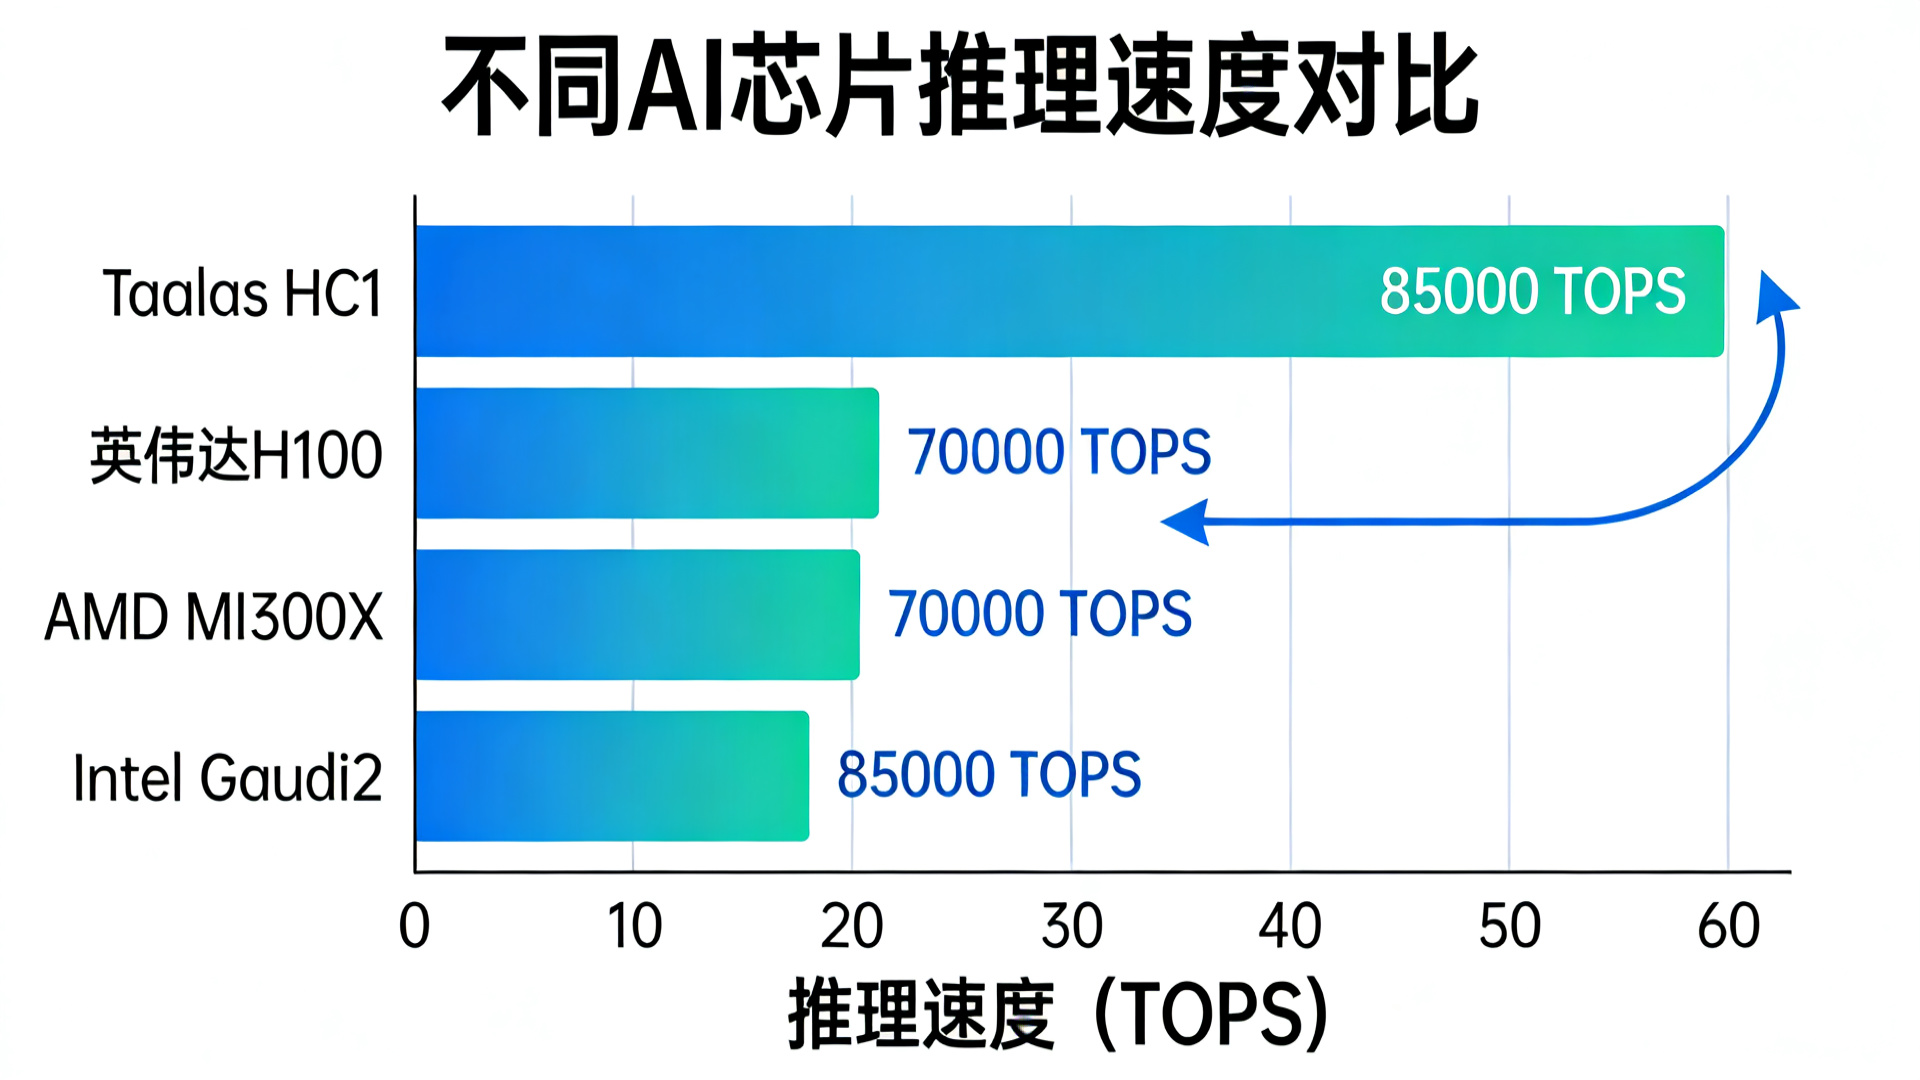
存算融合 + 结构化ASIC,重新定义AI推理效率
1000x带宽提升,彻底消除传统"内存墙"瓶颈。推理功耗降至GPU的1/10,能效比行业领先。
2个月流片周期,较传统ASIC大幅缩短。掩膜成本降低90%以上,快速响应市场需求。
17000tokens/秒推理速度,超英伟达B200约8.5倍,为大模型推理提供极致算力支撑。
1/20相比GPU方案,整体部署成本降至原来的二十分之一,大幅降低AI应用门槛。
从芯片到算力,提供全栈AI基础设施服务
提供灵活的算力租赁方案,支持按需购买、包月/包年模式,降低企业AI基础设施投入成本。
为企业客户提供基于Taalas HC1芯片的私有化算力中心建设方案,满足数据安全与合规需求。
基于自研芯片架构,提供大模型推理优化服务,包括模型量化、编译优化、推理加速等全链路支持。
探索存算融合技术在AI训练领域的应用,为特定训练任务提供定制化ASIC算力解决方案。
提供AI芯片选型、算力规划、架构设计等专业咨询,帮助企业制定最优AI基础设施策略。
开放芯片SDK与编译器工具链,完善开源生态,降低客户迁移成本,共建AI算力生态。
覆盖大模型推理、智能体、AIGC等多元场景
为LLM推理提供极致性价比算力,支持70B+参数大模型高效部署,适用于智能客服、内容生成等场景。
支撑大规模AI Agent并发运行,为自主决策、任务执行提供稳定高效的推理算力底座。
为文生图、文生视频等AIGC应用提供高性能推理算力,加速内容创作与分发效率。
帮助企业构建自有AI推理中台,统一管理模型部署与算力调度,实现AI能力的规模化应用。
Taalas HC1 大模型ASIC芯片核心指标