存算融合架构消除"内存墙",结构化ASIC技术流片周期缩短至2个月,
以极致性能与极致成本重新定义AI算力
从芯片架构到封装工艺,全栈自研的底层技术突破
突破传统冯·诺依曼架构瓶颈,将计算单元与存储单元深度融合,数据搬运带宽提升1000倍,彻底消除"内存墙"问题。推理功耗降至传统GPU方案的1/10,实现真正的极致能效比。
采用结构化ASIC设计方法论,流片周期从传统12-18个月缩短至仅2个月,掩膜成本降低90%以上。在保证高性能的同时,大幅缩短产品上市周期,降低芯片研发成本和风险。
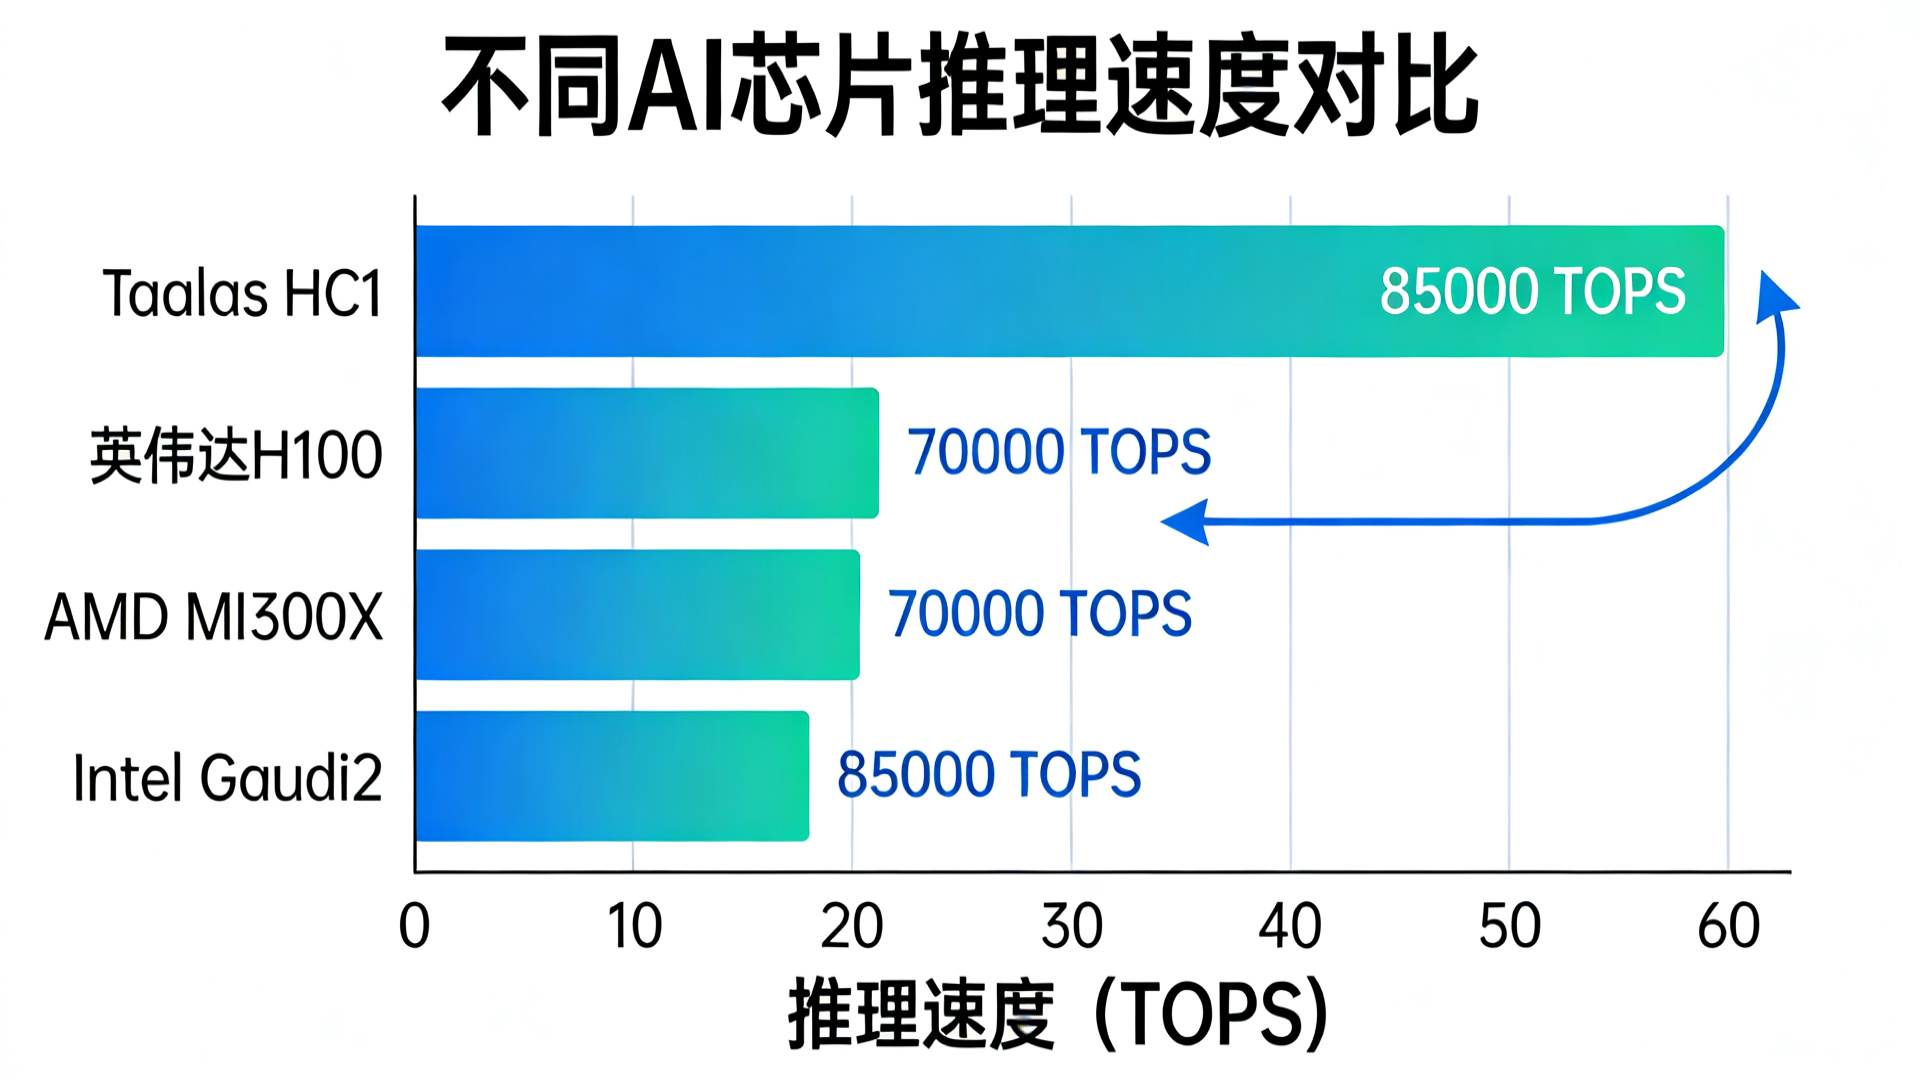
推理速度达17,000 tokens/秒,综合算力85,000 TOPS。在同等推理任务中,性能超英伟达B200约8.5倍、超H100约5倍,为大规模AI模型部署提供澎湃算力支撑。
整体方案成本仅为GPU方案的1/20,大幅降低AI大模型的部署门槛。无论是云端大规模部署还是边缘端实时推理,都能以更低的成本实现更强的AI能力。
对标行业主流AI芯片,全面领先
* 数据来源:公司内部测试及公开行业报告
四大核心优势,构建AI算力领域的竞争壁垒
存算融合设计从芯片底层突破算力瓶颈,不依赖传统架构的渐进式改良,实现代际领先。
结构化ASIC方案2个月即可流片,远超行业平均12-18个月的周期,快速响应市场需求变化。
从芯片设计到编译器软件栈,全栈自研、自主可控,不受外部供应链限制。
在稳固推理市场基础上,探索存算融合在AI训练领域的应用;紧跟3nm/2nm先进工艺,持续提升集成度与能效比。